Opinnäytetyö · Haaga-Helia
Vehicle Classifier
Tutkin opinnäytetyössäni, soveltuuko siirto-oppiminen ajoneuvojen luokitteluun liikennekuvista, kun laskentaresursseja on vähän. Toteutin PyTorchilla prototyypin, joka tunnistaa bussit, autot, kuorma-autot ja moottoripyörät.
89,25 %
Paras tarkkuus validointikuvista
83,75 %
Tarkkuus jo ensimmäisellä koulutuksella
568
Koulutuskuvaa per luokka
4/5
Opinnäytetyön arvosana
Mitä tein
Aihe on ajankohtainen, sillä tekoälyn ymmärtäminen madaltaa kynnystä hyödyntää sitä käytännössä, esimerkiksi liikennesuunnittelussa. Työ rajattiin yksittäisiin kuviin, reaaliaikaista videota ei käsitelty.
Tavoite
Toteuttaa prototyyppi, joka luokittelee liikennekuvat neljään luokkaan: henkilöautot, bussit, kuorma-autot ja moottoripyörät. Tavoitteena oli vähintään 80 % tarkkuus tavallisella kuluttajatietokoneella.
Tietoperusta
Kävin läpi koneoppimisen, syväoppimisen ja siirto-oppimisen peruskäsitteet sekä konvoluutioneuroverkkojen toiminnan. Lisäksi tarkastelin ResNet-mallia ja sen soveltuvuutta tehtävään.
Data
Käytin MIO-TCD-datasetin 50 000 kuvan osajoukkoa Kagglesta. Jokaisesta luokasta valitsin 568 koulutuskuvaa ja 100 validointikuvaa, jotka pidin omissa kansioissaan.
Toteutus
Toteutin mallin PyTorchilla. ResNet18:n kaikki kerrokset jäädytettiin ja vain viimeinen kerros korvattiin omalla neljän luokan kerroksella ja koulutettiin.
Koodia
Tässä projektin keskeiset osat. Koko lähdekoodi, mukaan lukien esikäsittelyskriptit ja visualisoinnit, löytyy GitHubista.
Malli ja siirto-oppiminen
Esikoulutettu verkko jäädytetään ja viimeinen kerros korvataan. Vain se koulutetaan.
# Ladataan esikoulutettu mallimodel = models.resnet18(weights='DEFAULT')# Jäädytetään kaikki kerroksetfor param in model.parameters(): param.requires_grad = False# Korvataan viimeinen kerros neljälle ajoneuvoluokallenum_classes = 4model.fc = nn.Linear(model.fc.in_features, num_classes)criterion = nn.CrossEntropyLoss()# Optimoidaan vain uutta viimeistä kerrostaoptimizer = optim.Adam(model.fc.parameters(), lr=0.001)Harjoitussilmukka
Jokaisella kierroksella (epoch) malli käy koulutuskuvat läpi erissä, laskee häviön ja päivittää painot.
num_epochs = 5for epoch in range(num_epochs): model.train() running_loss = 0.0 for images, labels in train_loader: images, labels = images.to(device), labels.to(device) optimizer.zero_grad() outputs = model(images) loss = criterion(outputs, labels) loss.backward() # gradientit (backpropagation) optimizer.step() # Adam päivittää painot running_loss += loss.item() epoch_loss = running_loss / len(train_loader) train_losses.append(epoch_loss)Tulokset: ensimmäinen koulutus
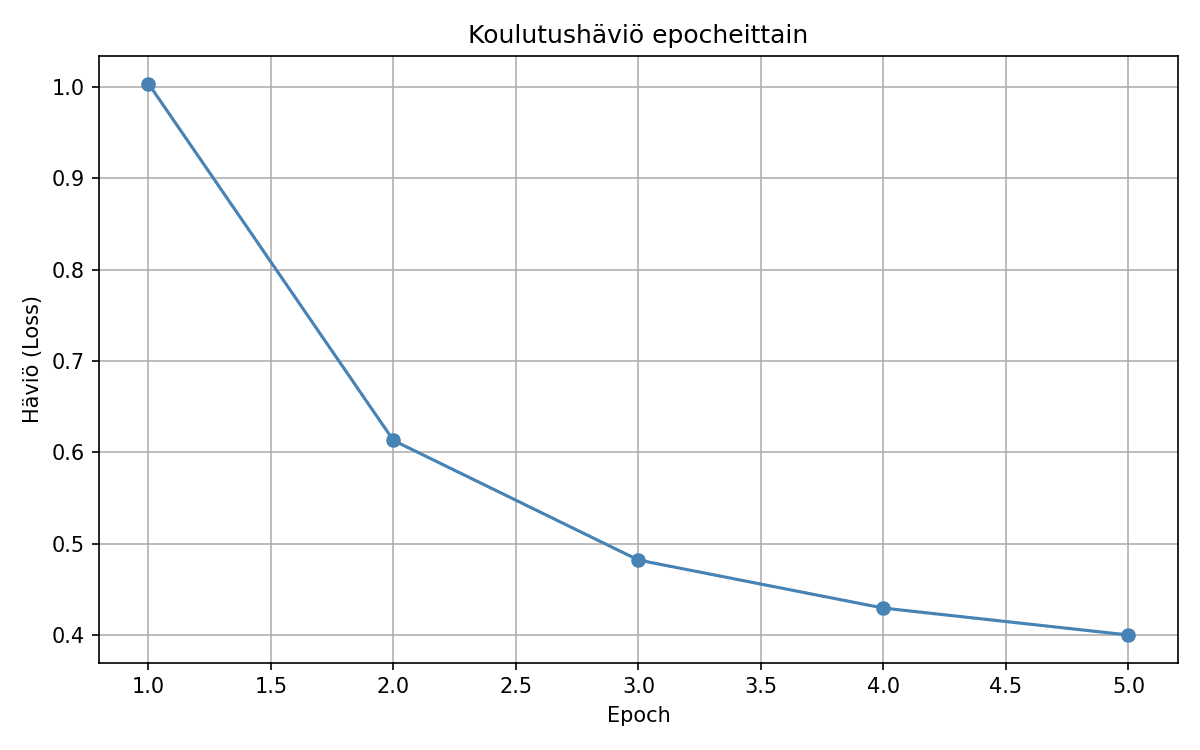
Oletusarvoilla (oppimisnopeus 0,001, eräkoko 32, 5 epochia) malli saavutti 83,75 %:n tarkkuuden validointikuvista ja ylitti 80 %:n tavoitteen. Koulutushäviö laski tasaisesti 1,0037:stä 0,3999:ään, eikä ylisovittumista (overfitting) näkynyt. Koulutus tehtiin tavallisella kuluttajatietokoneella ja vain 568 kuvalla per luokka.
Confusion matrix näyttää, missä malli on vahva. Moottoripyörällä on uniikki profiili, joten se tunnistettiin parhaiten. Suurin virhe oli kuorma-autojen sekoittuminen busseihin: 15 kuorma-autoa luokiteltiin busseiksi.

Luokkakohtainen tarkkuus: kuinka suuri osa luokan validointikuvista tunnistettiin oikein.
94 %
Moottoripyörä
92 %
Bussi
76 %
Henkilöauto
73 %
Kuorma-auto
Esimerkkiennusteet
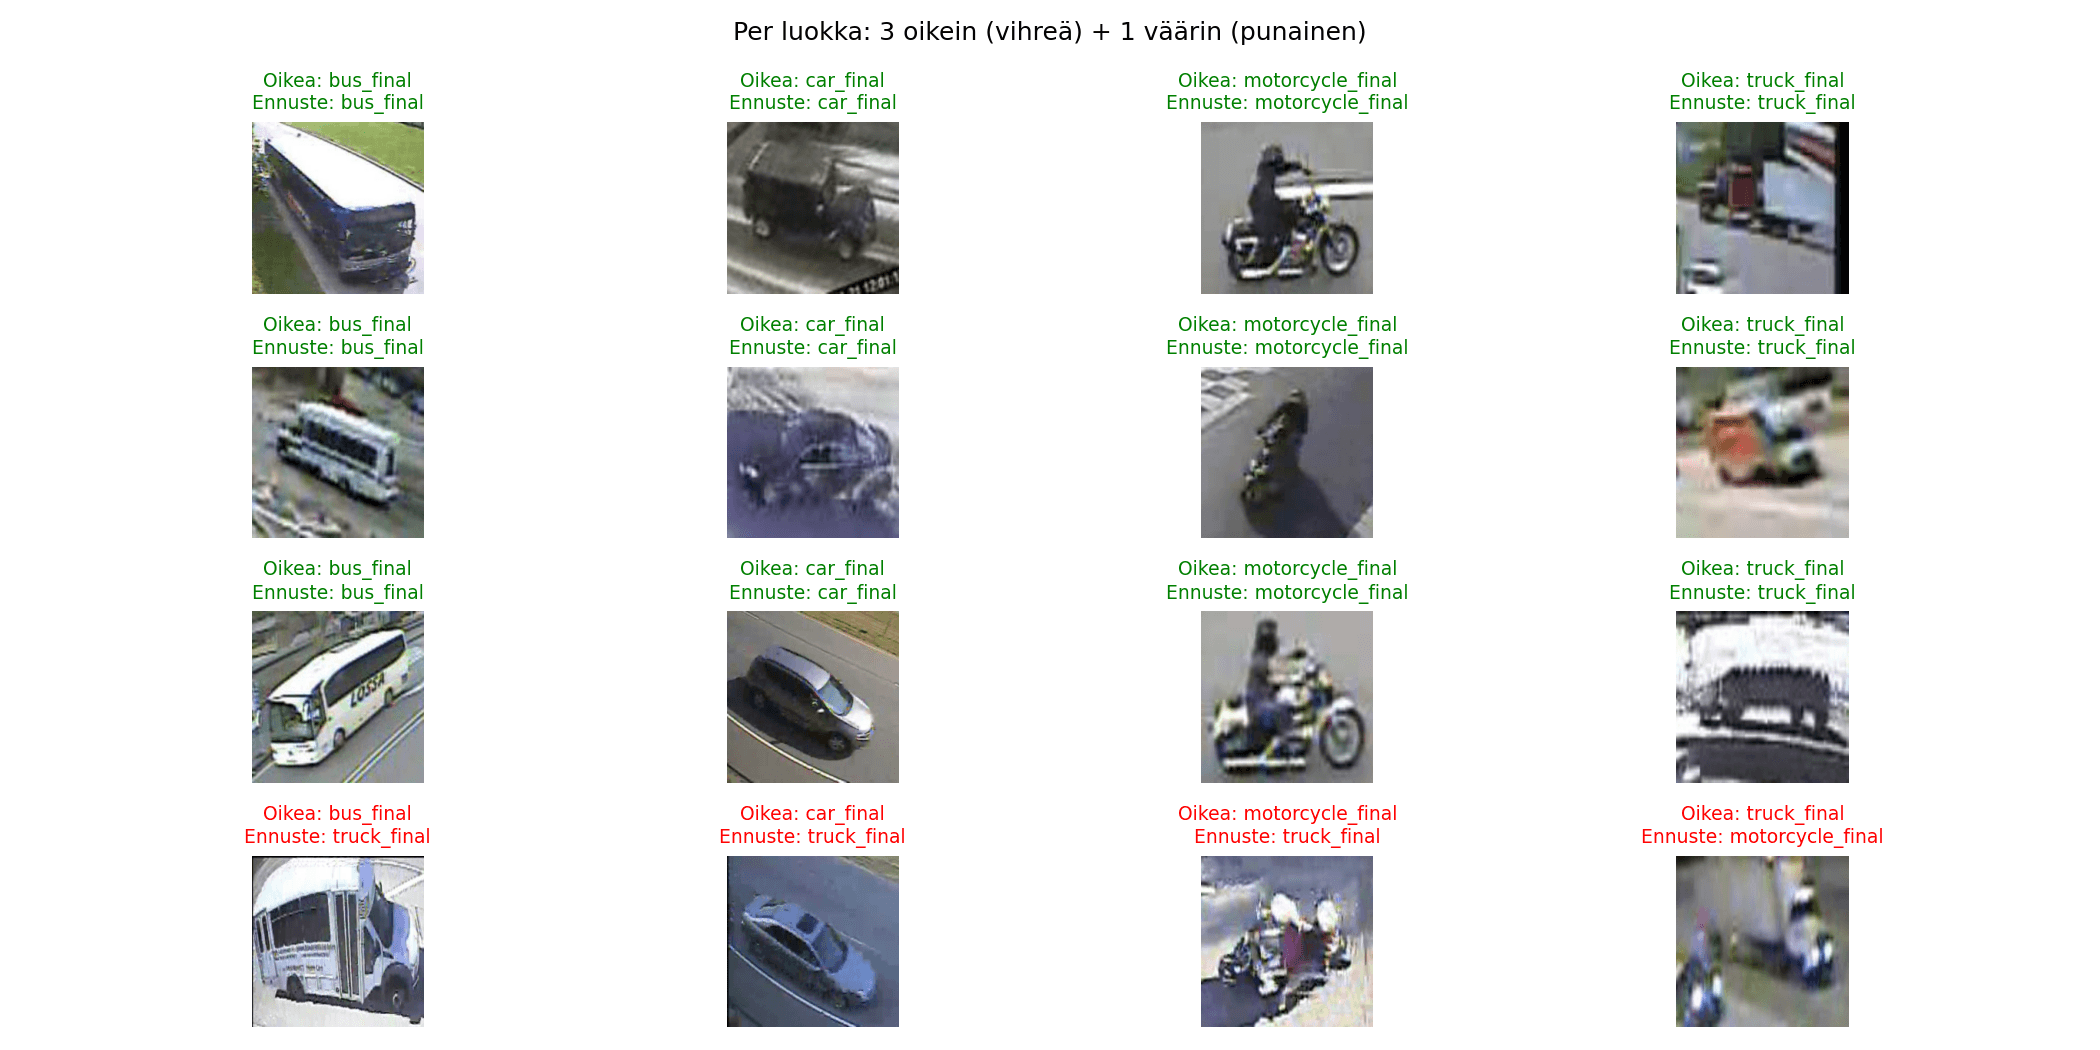
Jokaisesta luokasta kolme oikein (vihreä) ja yksi väärin luokiteltu kuva (punainen). Yksi henkilöauto meni kuorma-autosta, vaikka se on ihmissilmälle selvästi auto. Samalla osa erittäin epätarkoista kuvista tunnistettiin oikein.
Hyperparametrien optimointi
Muutin yhtä hyperparametria kerrallaan, jotta jokaisen vaikutus näkyi selvästi. Vertailukohta oli ensimmäisen koulutuksen 83,75 %.
| Testitapaus | Learning rate | Batch | Epochit | Tarkkuus % | Häviö |
|---|---|---|---|---|---|
| Pohjatulos | 0,001 | 32 | 5 | 83,75 | 0.3999 |
| Batch size 8 | 0,001 | 8 | 5 | 86,75 | 0,5096 |
| Batch size 16 | 0,001 | 16 | 5 | 87,25 | 0,4133 |
| Batch size 64 | 0,001 | 64 | 5 | 82,75 | 0,4239 |
| Batch size 128 | 0,001 | 128 | 5 | 81,25 | 0,5078 |
| Learning rate 0,01 | 0,01 | 32 | 5 | 89,25 | 0,3210 |
| Learning rate 0,0001 | 0,0001 | 32 | 5 | 72,25 | 0,8727 |
| Learning rate 0,00001 | 0,00001 | 32 | 5 | 37,75 | 1,3529 |
| Epochit 10 | 0,001 | 32 | 10 | 86,50 | 0,2836 |
| Epochit 15 | 0,001 | 32 | 15 | 87,25 | 0.2425 |
| Epochit 25 | 0,001 | 32 | 25 | 87,50 | 0,2147 |
| Epochit 50 | 0,001 | 32 | 50 | 88,25 | 0,1548 |
Oppimisnopeus
Malli oli herkkä askelkoolle. Nopeus 0.01 antoi parhaan tuloksen (89,25 %), kun taas 0.00001 ei oppinut viidessä epochissa juuri mitään (37,75 %).
Eräkoko
Pienempi eräkoko 16 paransi tarkkuutta (87,25 %). Suuret koot 64 ja 128 oppivat liian hitaasti viidessä epochissa.
Koulutuskierrokset
15 epochista 50:een tarkkuus nousi vain yhden prosenttiyksikön, mutta häviö putosi lähes puoleen (0.2425 → 0.1548). Malli ei oppinut paljon uutta, mutta varmuus kasvoi.
Parhaiden arvojen yhdistäminen ei toiminut
Oletin, että oppimisnopeus 0,01, eräkoko 16 ja 25 epochia yhdessä antaisivat parhaan mallin. Tarkkuus jäi kuitenkin 86,75 %:iin, eikä se ylittänyt parasta yksittäistä tulosta.
Häviökuvaaja paljasti syyn: häviö hyppeli epäsäännöllisesti koko koulutuksen ajan. Suuri oppimisnopeus ja pieni eräkoko yhdessä tekivät painojen päivityksistä liian voimakkaita. Hyperparametrit eivät siis ole toisistaan riippumattomia.

Johtopäätökset ja oppiminen
Paras tulos 89,25 % ylitti 80 %:n tavoitteen lähes kymmenellä prosenttiyksiköllä. Raskainkin koulutus, 50 epochia, vei vain muutaman minuutin tavallisella tietokoneella. Siirto-oppiminen osoittautui tehokkaaksi tavaksi toteuttaa malli rajallisilla resursseilla.
Tuloksista voi poimia kaksi konfiguraatiota: nopeaan prototyyppiin oppimisnopeus 0,01 oletusarvoilla, ja vakaampaan tulokseen oletusnopeus 0,001 ja 25 epochia.
Jatkokehitys olisi reaaliaikainen videotunnistus ja koulutusdatan kasvattaminen 568 kuvasta esimerkiksi 5 000:een per luokka. Tuloksia ei voi suoraan yleistää suurempaan luokkamäärään tai videokuvaan.
Aloitin ilman aiempaa kokemusta tekoälymallien kehittämisestä. Työssä opin kouluttamaan ensimmäisen koneoppimismallini, käyttämään PyTorchia käytännössä ja ymmärtämään hyperparametrien vaikutuksen.
Opin myös, ettei pelkkä tarkkuusprosentti riitä: confusion matrix ja häviökuvaaja paljastivat asioita, jotka luku yksin piilotti. Matkalla ratkaisin esimerkiksi CUDA-asennuksen ja kirjoitin skriptin, joka siirsi validointikuvat erilleen koulutuskuvista.